ChatGPT、Claude、Geminiといった生成AIサービスの普及により、「AIインフラ」という言葉を耳にする機会が増えています。従来のITインフラとは何が違うのか、その基本と仕組みを解説します。
この分野を実際に担う職種については[AIインフラエンジニアとは?仕事内容・必要スキル・キャリアを解説]で詳しく解説しています。
- AIインフラとは何か、従来のITインフラとの違い
- AIインフラを構成する主要な要素(ハードウェア・ソフトウェア)
- AIインフラが重要視される理由
1.AIインフラとは
AIインフラとは、AI(人工知能)や機械学習(MLのモデル開発・学習・デプロイ・運用といった一連のライフサイクル全体を支えるIT基盤の総称です。
AIがビジネスや研究開発に不可欠となった現代において、その性能を最大限に引き出すための土台となる重要な存在です。
1-1.従来のITインフラとの違い
| 項目 | 従来のITインフラ | AIインフラ |
|---|---|---|
| 中心となる処理装置 | CPU | GPU・TPU等のAIアクセラレーター |
| 得意な処理 | 決められた処理を順番に確実に処理 | 大量の並列計算(行列・ベクトル演算) |
| 重視される点 | 幅広い互換性・安定性 | 高スループット・低遅延 |
| ネットワーク | 一般的な帯域で十分な場合が多い | 高速インターコネクト(InfiniBand等)が必要 |
なぜこうした違いが生まれるかというと、AIの計算ではモデルとデータをGPUメモリ上に載せて一気に処理するため、GPUの枚数・メモリ容量・データを供給する速度が性能を大きく左右するためです。従来のCPU中心の設計思想とは、そもそも得意な処理が異なります。
2.AIインフラを構成する要素
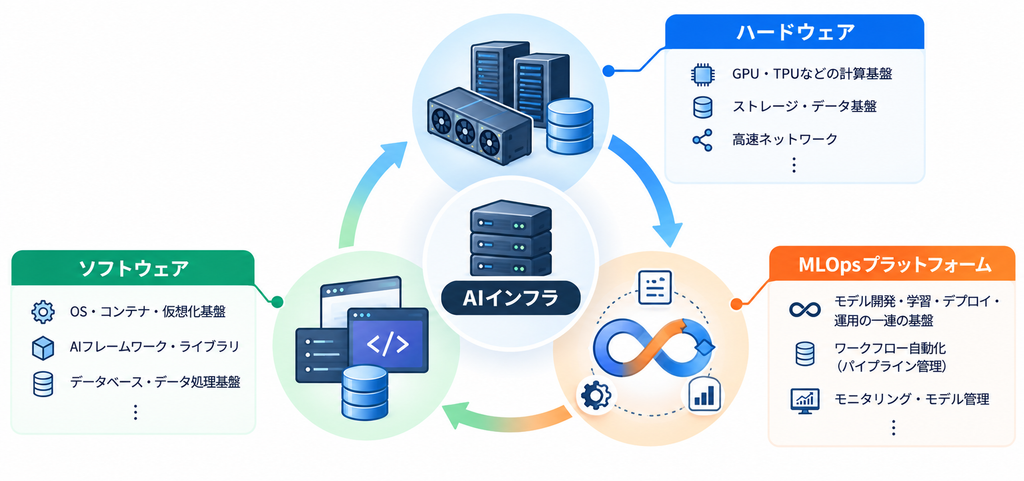
AIインフラは、ハードウェア、ソフトウェア、MLOpsプラットフォームの3つの要素が有機的に連携することで成り立っています。
2-1.ハードウェア
GPU・TPUサーバーが中核となり、それを支える大容量メモリ、高速ストレージ、高速ネットワークで構成されます。AIの計算では大量のデータをGPUに供給し続ける必要があるため、ストレージやネットワークの速度もボトルネックになりやすい部分です。
また、GPUサーバーは大量の電力を消費するため、電力供給と冷却設備までを含めた設計が求められます。GPUサーバーを高密度に並べすぎると熱がこもり冷却効率が落ちるため、ラックの配置設計も性能に直結する重要な要素です。
2-2.ソフトウェア
PyTorchやTensorFlowといった機械学習フレームワーク、大規模なモデルを複数のGPU・サーバーに分散させて学習させるための分散トレーニングフレームワーク、Docker(コンテナ技術)とKubernetes(オーケストレーション)、そして学習済みモデルを低遅延で応答させるための推論スタックが含まれます。
2-3.MLOpsプラットフォーム
AIワークフローに合わせたCI/CDパイプラインを含み、モデルの学習から本番デプロイ、そして継続的な改善までのサイクルを支える仕組みです。AIを単なる実験(PoC)で終わらせず、ビジネスに継続的に貢献させるための土台になります。
3.AIインフラが重要視される理由
AIインフラが不可欠なのは、主に3つの目的を達成するためです。
- 大規模なデータ処理と高速な計算能力の確保
AIモデルの学習には膨大な量のデータと計算リソースが必要で、これを支える専用の基盤が欠かせません。 - AI開発ライフサイクルの高速化
モデルの試行錯誤を素早く繰り返せる環境があることで、開発のスピードそのものが競争力に直結します。 - MLOps実現による継続的なモデル改善
一度作ったモデルを作りっぱなしにせず、運用データを元に継続的に改善し続けるサイクルを支えます。
AIインフラの需要拡大は、それを支えるエンジニアの需要拡大とも直結しています。GPUクラスターの運用や分散学習の最適化といった専門知識を持つ人材は、市場価値が高い状態が続いています。
4.クラウドとオンプレミス、どちらを選ぶべきか
AIインフラを構築する際、クラウドとオンプレミスのどちらを選ぶかは重要な判断ポイントです。
4-1.クラウド(AWS、GCP、Azure等)
初期投資を抑えられ、需要に応じて計算リソースを柔軟にスケールできるのが最大の利点です。GPUサーバーを自社で購入・管理する必要がないため、多くの企業がまず検討する選択肢になります。一方で、利用量が多くなるほど継続的なコストがかさみやすい点は注意が必要です。
4-2.オンプレミス
大規模かつ継続的にGPUを利用する場合、長期的なコスト効率に優れる場合があります。ただし、GPU等の高価なハードウェアを自社で調達・管理する必要があり、電力・冷却設備への投資や、専門知識を持つ人材の確保も必要になります。
4-3.選び方の考え方
自社の利用規模、予算、運用体制に応じて判断するのが実務的なアプローチです。利用量が変動しやすい、まず小さく試したいという場合はクラウドが向いています。逆に、大規模な学習を継続的に行う前提がある場合は、オンプレミスとの併用(ハイブリッド)も含めて検討する価値があります。
5.まとめ
AIインフラは、GPU等の専用ハードウェアと、MLOpsを含むソフトウェアが組み合わさって成り立つ、AI開発を支える基盤です。従来のITインフラがCPU中心の安定性・互換性を重視するのに対し、AIインフラはGPUを中心とした高スループット・低遅延の実現に重点を置きます。
クラウドとオンプレミスにはそれぞれ利点があり、自社の利用規模や予算に応じた選択が求められます。この分野で活躍する「AIインフラエンジニア」という職種の仕事内容・必要スキル・年収については、[AIインフラエンジニアとは?仕事内容・必要スキル・キャリアを解説]で詳しく解説しています。